בתרגול זה נבנה את החלק השני והמרגש של מערכת ה-RAG (Retrieval-Augmented Generation) שלנו. לאחר שבתרגיל הקודם לקחנו מסמך PDF, פירקנו אותו ואינדקסנו אותו לתוך Pinecone, כעת נבנה את ה"מוח" שיודע להשתמש בידע הזה. נבנה Flow ב-n8n שמקבל שאלת משתמש (למשל, "מה שעות ארוחת הבוקר?"), מחפש את התשובות הרלוונטיות ביותר בבסיס הידע הוקטורי שלנו, ואז מעביר את המידע שמצא, יחד עם השאלה המקורית, למודל שפה (LLM) כדי שינסח תשובה מדויקת ומבוססת-ידע.
זהו לב-ליבה של פיתוח סוכנים אוטונומיים: היכולת לבסס תשובות על מאגר ידע חיצוני ודינמי, במקום להסתמך רק על הידע ה"אפוי" של מודל השפה. אנו נלמד כיצד לשרשר את קבלת הקלט, יצירת ה-Embedding לשאילתה, החיפוש הוקטורי, ולבסוף את יצירת הפרומפט הסופי למודל ה-LLM.
בהצלחה!
פרק 1: הקמת הסוכן והגדרת הטריגר
בפרק זה נבנה את השלד של הסוכן: נקודת הכניסה (הצ'אט) ואת בלוק ה-AI Agent המרכזי שינהל את כל הפעולות.
הכנה:
לפני שמתחילים, ודאו שיש לכם את הפרטים הבאים מהתרגולים הקודמים:
- OpenAI API Key
- Pinecone API Key
- Pinecone Index (לדוגמה:
agent-masterclass) – ודאו שיש בו נתונים שהעליתם בתרגול הקודם!
-
יצירת תהליך הצ׳אט
- צרו Workflow חדש וריק ב-n8n.
- הוסיפו טריגר מסוג "When chat message received".
- זה ישמש אותנו בשלב הראשון. בהמשך נרחיב את הפונקציונליות ונחבר את הסוכן להגיב לשאלות במייל.
- חברו אליו Node מסוג "AI Agent".
-
הגדרת המודל והוראות המערכת (System Message):
-
הוסיפו לסוכן את מודל השפה. הקליקו על יציאת Chat Model בתחתית הבלוק, ובחרו במודל כרצונכם מהגלריה.
הפעם נשתמש דווקא במודל מהשירות Open Router. שירות זה מאפשר לכם להשתמש בעשרות מודלי שפה של ספקים שונים דרך API Key יחיד. הוא מחזיק מודלים של OpenAI, Google, Claude ועוד. על מנת להשתמש בשירות זה יש לפתוח חשבון OpenRouter, לחבר אמצעי תשלום, וליצור API Key חדש. תהליך ההרשמה והחיבור דומה מאוד לזה של OpenAI, ולא נכסה כאן את כל ההסברים.
אנחנו נבחר במודלclaude-sonnet-4.5של OpenRouter, אבל מי שמעוניין להשאר בשירות OpenAI, יכול לבחור משם מודל גדול יחסית כמוgpt-4o, בעל יכולת ניסוח גבוהה יותר.
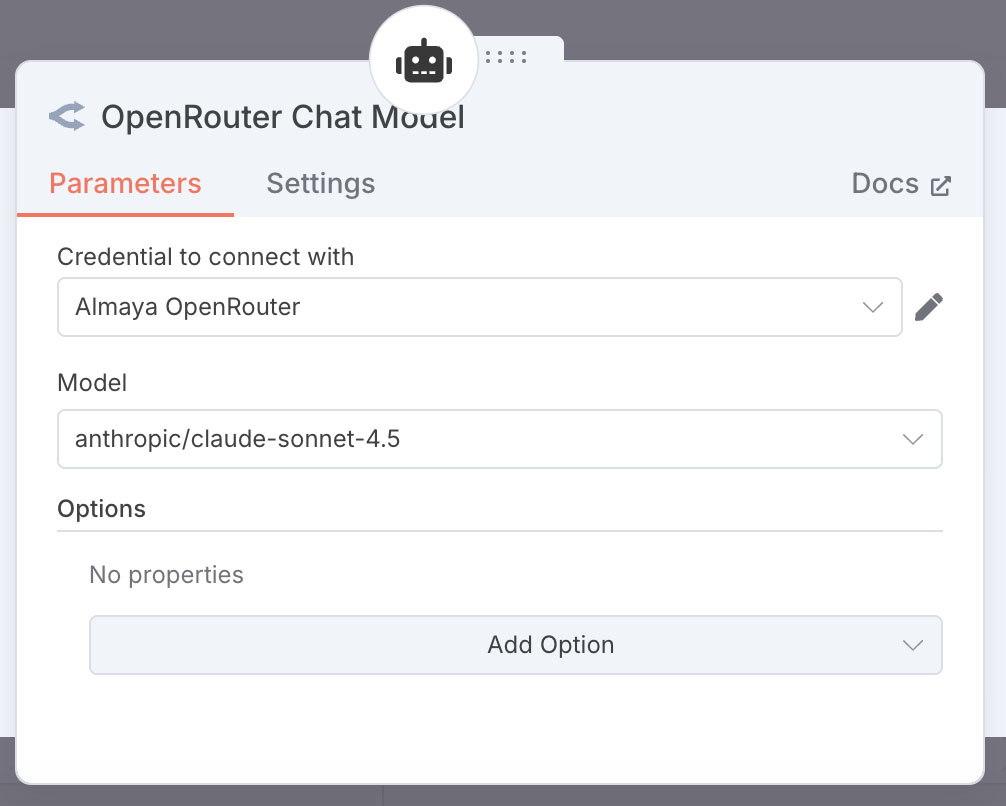
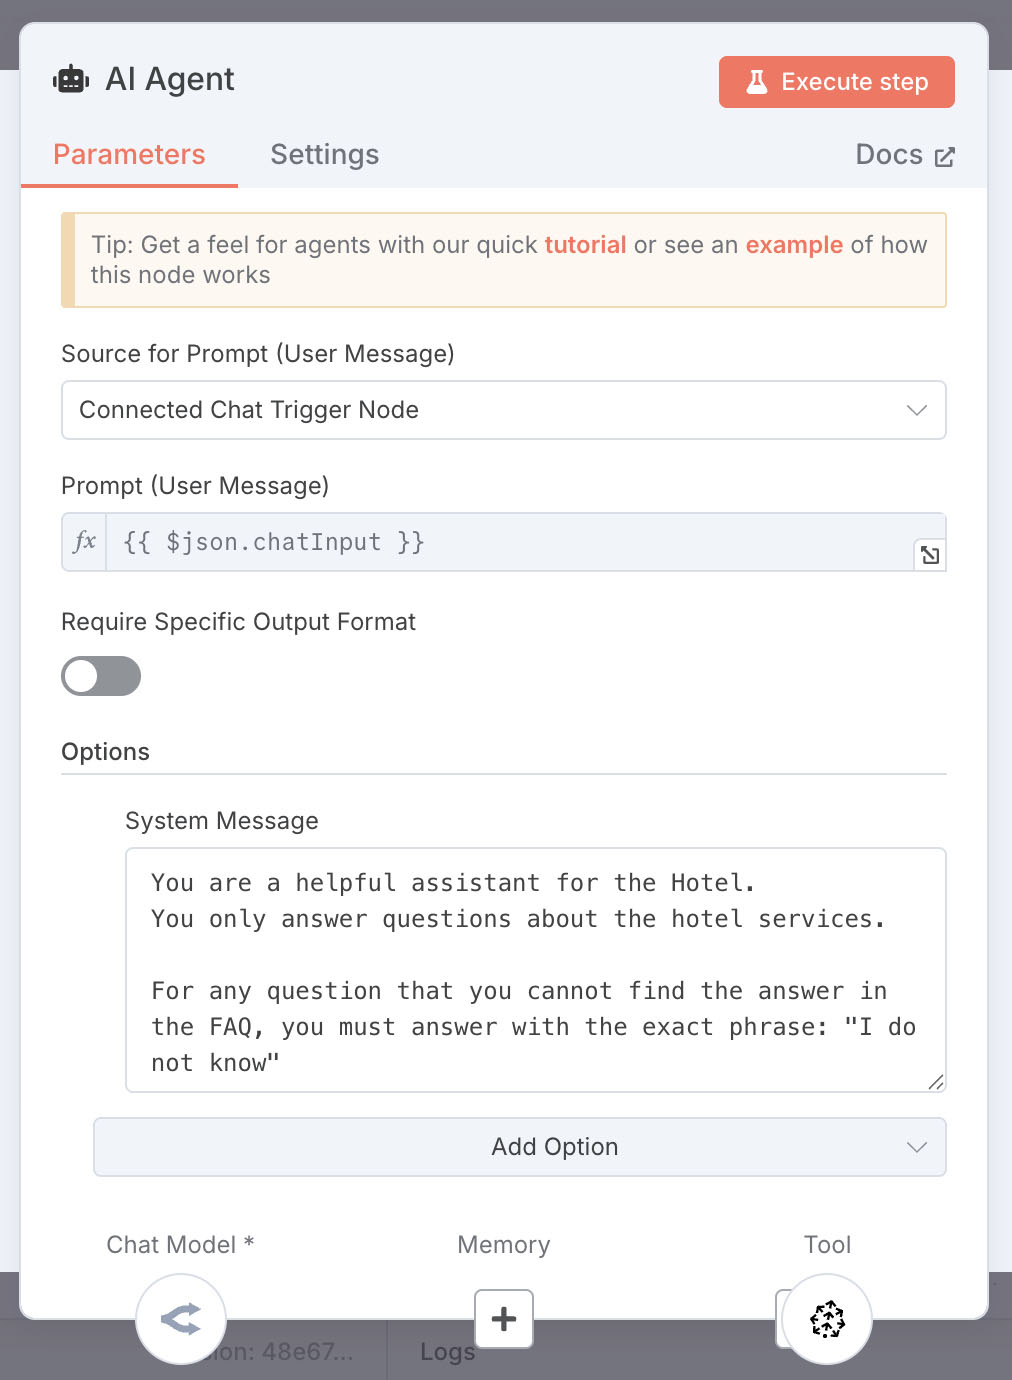
מודל צ׳אט – OpenRouter - כעת נגדיר הוראות מערכת ראשוניות – על מנת למקד את הסוכן למשימה הספציפית. בתוך הגדרות בלוק ה-AI Agent, הוסיפו את השדה "System Message".
-
הדביקו בשדה זה את הטקסט הבא (זהו הטקסט מקובץ ה-JSON שסיפקת):
You are a helpful assistant for the Hotel. You only answer questions about the hotel services. For any question that you cannot find the answer in the FAQ, you must answer with the exact phrase: "I do not know" -
הוראה זו קריטית: היא מנחה את הסוכן לענות רק על שאלות מהמלון, ומגדירה לו מה לעשות כשהוא לא מוצא תשובה בידע (להגיד "I do not know" במדויק).
-
הוסיפו לסוכן את מודל השפה. הקליקו על יציאת Chat Model בתחתית הבלוק, ובחרו במודל כרצונכם מהגלריה.
פרק 2: חיבור יכולות ה-RAG לסוכן
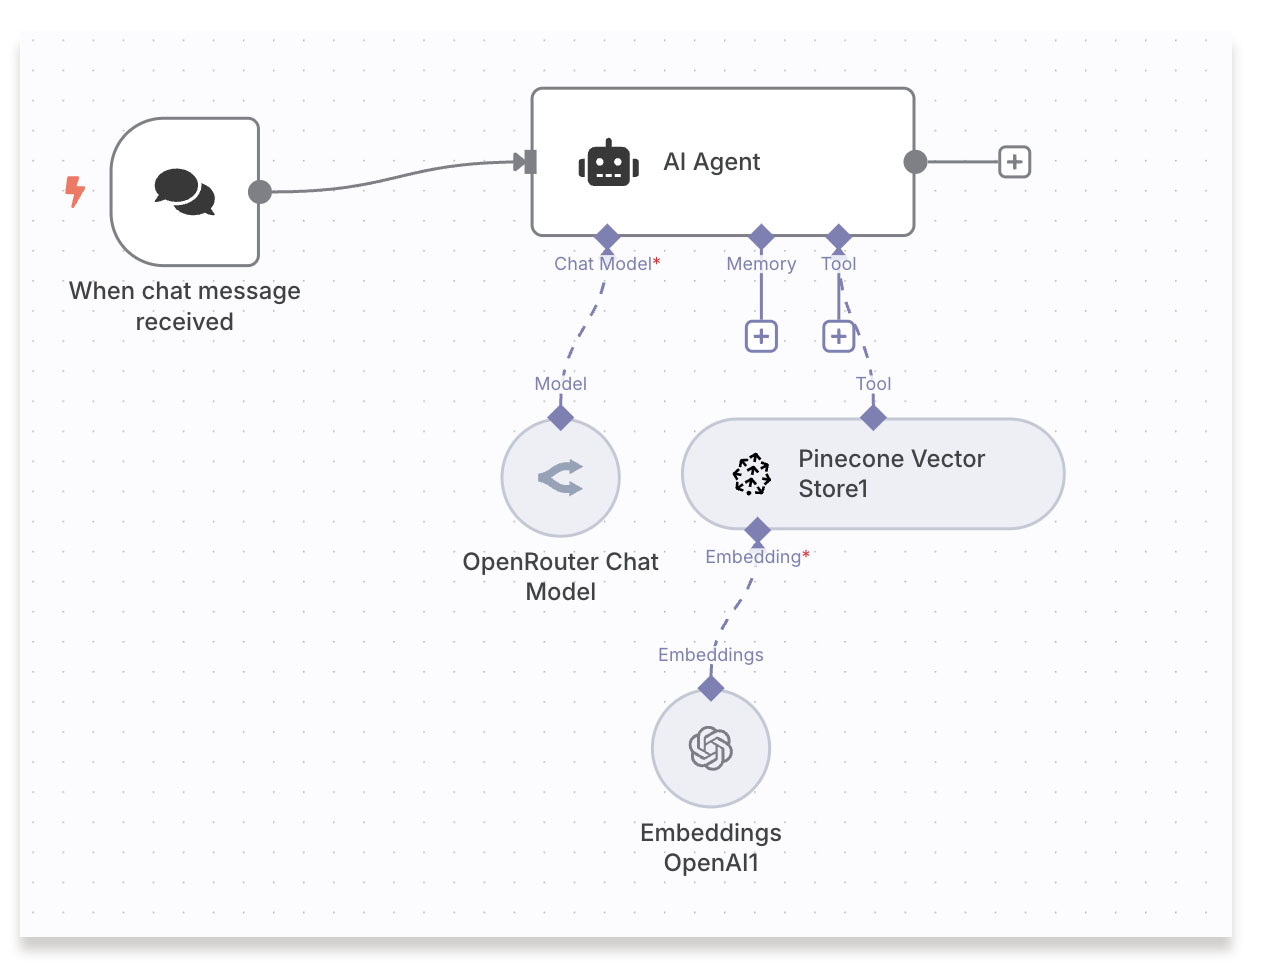
בלוק ה-AI Agent עובד במודל "מרכז וחיבורים" (Hub and Spoke). הוא ה"מנהל", ואנו מחברים אליו את הכלים והיכולות שהוא צריך. כעת נחבר אליו את ה"מתרגם" (Embeddings) וה"זיכרון" (Pinecone).
-
חיבור בסיס הידע (Pinecone Vector Store):
- בבלוק Ai Agent, תחת יציאת Tools בתחתית הבלוק, חברו כלי בשם Pinecone Vector Store. שימו לב – זה לא בלוק נוסף, אלא כלי עזר לבלוק הראשי של Ai Agent!
- זהו לב ה-RAG. כאן נגדיר את החיבור לבסיס הנתונים שבנינו.
-
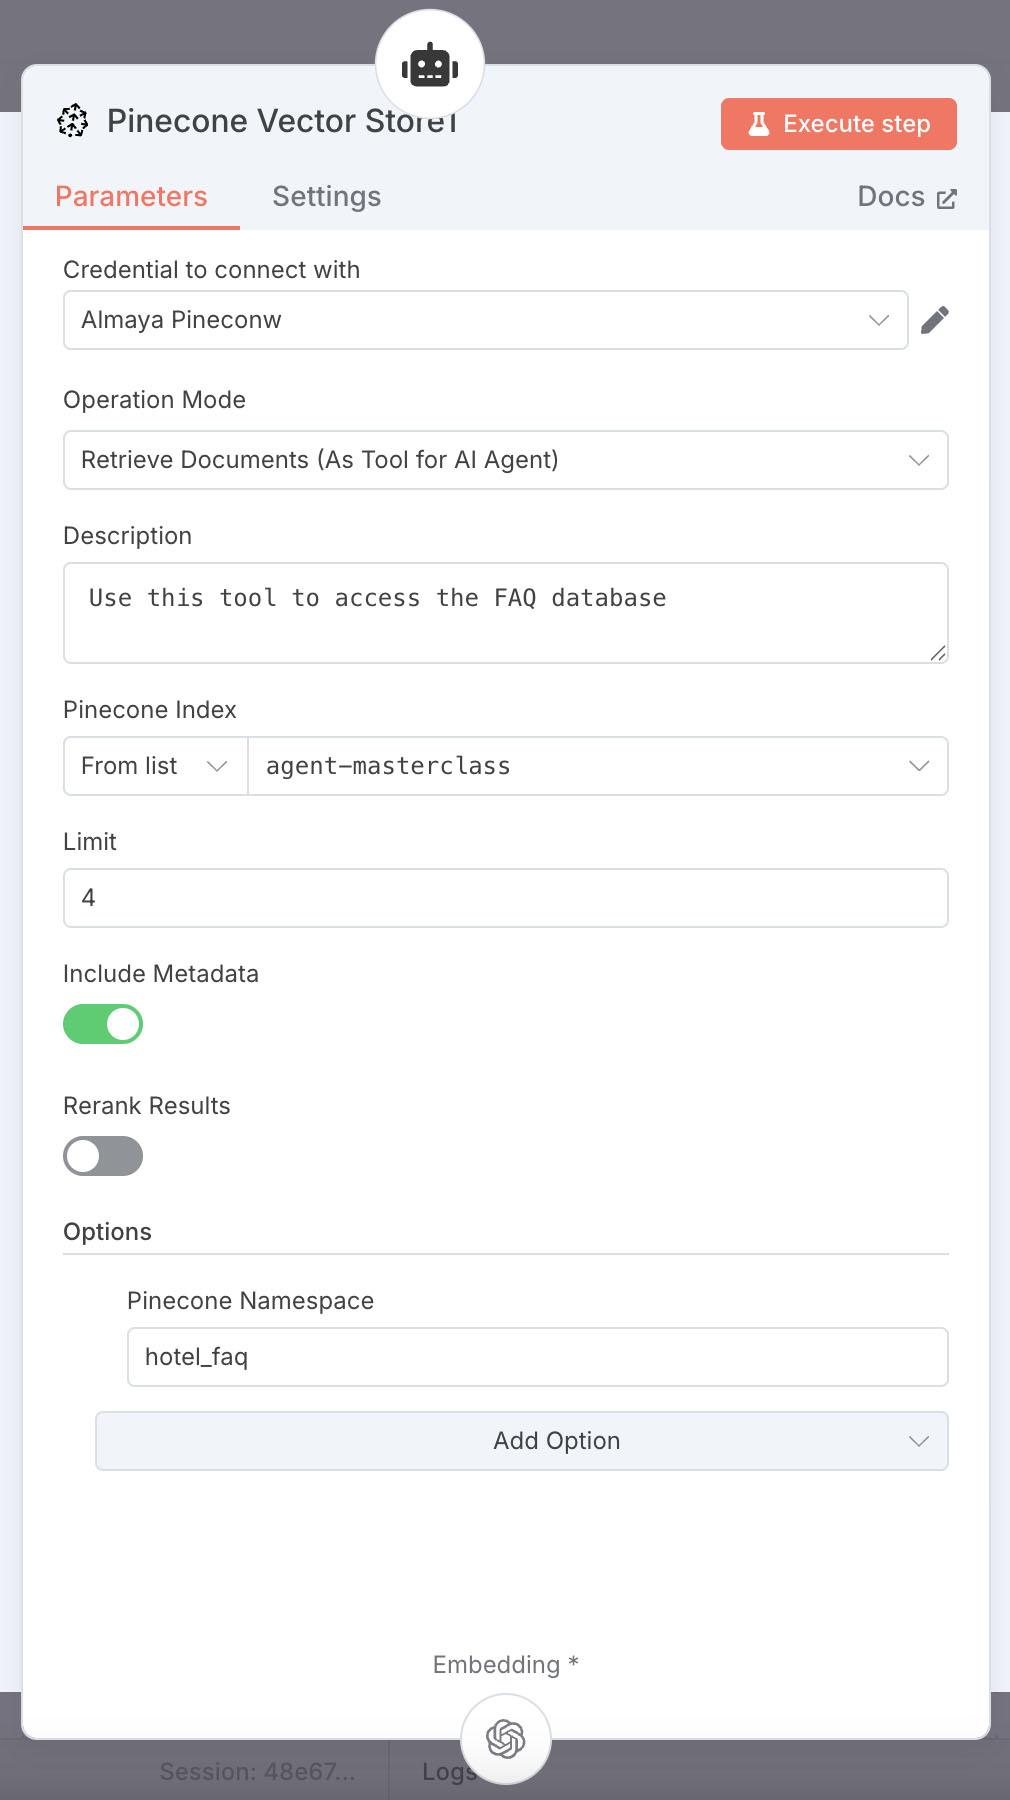
בתוך הגדרות הבלוק:
- Credential: ודאו שימוש ב Pinecone Credential שיצרתם.
- Operation Mode: ודאו שהפעולה היא Retrieve Document (שאילתה).
- Description: הכניסו את הטקסט הבא – תיאור השימוש בכלי:
Use this tool to access the FAQ database - Pinecone Index: בחרו את האינדקס שלכם מתוך הרשימה הנפתחת.
-
Namespace: על מנת לגשת ל Namespace הספציפי של ה hotel FAQ שיצרנו, תחת Options הוסיפו שדה נוסף – Pinecone Namespace, והכניסו את שם ה Namespace (למשל,
hotel-faq).
-
חיבור מודל ההטמעה (Embedding Model):
- בתחתית הגדרות הכלי Pinecone, לחצו על היציאה Embedding וחברו אותה למודל Embeddings OpenAI.
-
בשדה סוג המודל (Model) בחרו באותו המודל שהשתמשנו בו לאינדוקס:
text-embedding-3-small. -
תחת Options, הוסיפו שדה Dimension, וקבעו אותו לערך
512. -
חשוב מאוד: המודל וה-Dimension שנבחר לצורך שליפת המידע מהזיכרון חייבים להיות זהים לאלו שהשתמשנו בהם לצורך השמירה של המידע, אחרי הזיכרון לא יהיה יכול לשלוף את הנתון הרלוונטי כראוי.
כמו״כ – שימו לב שאנחנו משתמשים כאן בשני מודלים שונים:
- מודל השיחה (Chat Model) משמש את הסוכן לנהל את הפעילות, לקבל החלטות ולנסח את הפלט למשתמש.
- מודל ההטמעה (Embedding) אחראי רק להפוך את השאלה של המשתמש לערכים מספריים לצורך החיפוש בזיכרון של Pinecone
- תפקיד הבלוק הזה: לקחת את השאלה של המשתמש (למשל, "מתי ארוחת בוקר?") ולהפוך אותה לוקטור מספרי שה"זיכרון" (Pinecone) יהיה יכול להבין.
פרק 3: בדיקת הסוכן החכם
כעת, כשהכל מחובר, הגיע הזמן לבדוק את הסוכן שלנו.
-
שאילת שאלות "מהידע":
- שמרו את ה workflow ופתחו את ממשק הצ׳אט.
-
בחלון הצ'אט, שאלו שאלה שהתשובה עליה נמצאת בבירור בקובץ ה-PDF שהעליתם. לדוגמה:
What are the breakfast hours? - שימו לב: הסוכן יקבל את השאלה, ה-Embeddings יהפוך אותה לוקטור, ה-Pinecone יחפש תשובות רלוונטיות, וה-LLM ינסח תשובה סופית על בסיס המידע מ-Pinecone.
- ודאו שהתשובה המתקבלת אכן נכונה ומבוססת על ה-FAQ שלכם.
-
בדיקת ה"גדר" (Guardrail):
-
כעת, בדקו את ה-System Message. שאלו שאלה שאינה קשורה למלון:
What is the capital of France? - אם הכל הוגדר כראוי, הסוכן לא יחפש ב-Pinecone (כי השאלה לא רלוונטית) ולא יענה "Paris".
- הוא אמור לענות לכם בדיוק את המשפט שהגדרנו לו: "I do not know".
- אם קיבלתם את התשובה הזו – הצלחתם! בנייתם סוכן מבוסס ידע עם גבולות גזרה ברורים.
-
כעת, בדקו את ה-System Message. שאלו שאלה שאינה קשורה למלון:
תרגול פתוח
כעת, נסו "ללכלך את הידיים" ולחקור בעצמכם:
-
שנו את ה-System Message:
- שנו את המשפט "I do not know" למשהו בעברית, למשל: "אני מצטער, אני יכול לענות רק על שאלות שקשורות למלון."
- הוסיפו לו "אופי". למשל: "You are a very enthusiastic and happy hotel assistant". בדקו איך זה משפיע על סגנון התשובות.
-
חקרו את נתוני הריצה:
- לאחר הרצת שאילתה, לחצו על בלוק ה-AI Agent ובדקו את נתוני הפלט (Output).
-
תוכלו לראות שם את ה-
context– אלו חתיכות הטקסט המדויקות ש-Pinecone שלף והעביר ל-LLM כדי שינסח את התשובה.
-
שנו את מודל ה-LLM:
-
בבלוק OpenAI Chat Model, נסו להחליף מ-
gpt-3.5-turboל-gpt-4o-mini(אם יש לכם גישה). האם התשובות משתפרות?
-
בבלוק OpenAI Chat Model, נסו להחליף מ-
-
אתגר: חיבור הסוכן למייל של המלון
-
כעת נסו לנתק את ממשק הצ׳אט של n8n, וחברו במקומו טריגר של Gmail. שימו לב לשנות את בלוק ה Ai Agent כך שיקבל את הקלט שלו באופן של "Define Below" ולא מתוך ממשק הצ׳אט.
לסיום חברו בלוק נוסף של Gmail ביציאת בלוק הסוכן, השתמשו בפלט שמוחזר מהסוכן, וקבעו את ה-Operation ל Reply. שימו לב לחבר את שדה ה Messade ID לנתון הנכון.
-
כעת נסו לנתק את ממשק הצ׳אט של n8n, וחברו במקומו טריגר של Gmail. שימו לב לשנות את בלוק ה Ai Agent כך שיקבל את הקלט שלו באופן של "Define Below" ולא מתוך ממשק הצ׳אט.
סיכום:
בתרגול זה בנינו סוכן RAG מלא. למדנו שה-AI Agent ב-n8n משמש כ"מנהל" מרכזי, ואנו מחברים אליו את היכולות הדרושות לו: מודל שפה לחשיבה, מודל Embeddings ל"תרגום" סמנטי, ומסד נתונים וקטורי כ"זיכרון" ארוך טווח. כעת יש לכם סוכן שיכול לענות על שאלות מתוך מאגר ידע דינמי, וחשוב מכך – יודע מתי לומר "אני לא יודע".